
Test cuestionario de análisis de datos
Estructura de medición
¿Quiénes suelen realizar esta prueba?
Descubre cómo se compara
A continuación, te ofrecemos una vista previa de los puntos de referencia que utilizamos para situar tu puntaje en contexto.
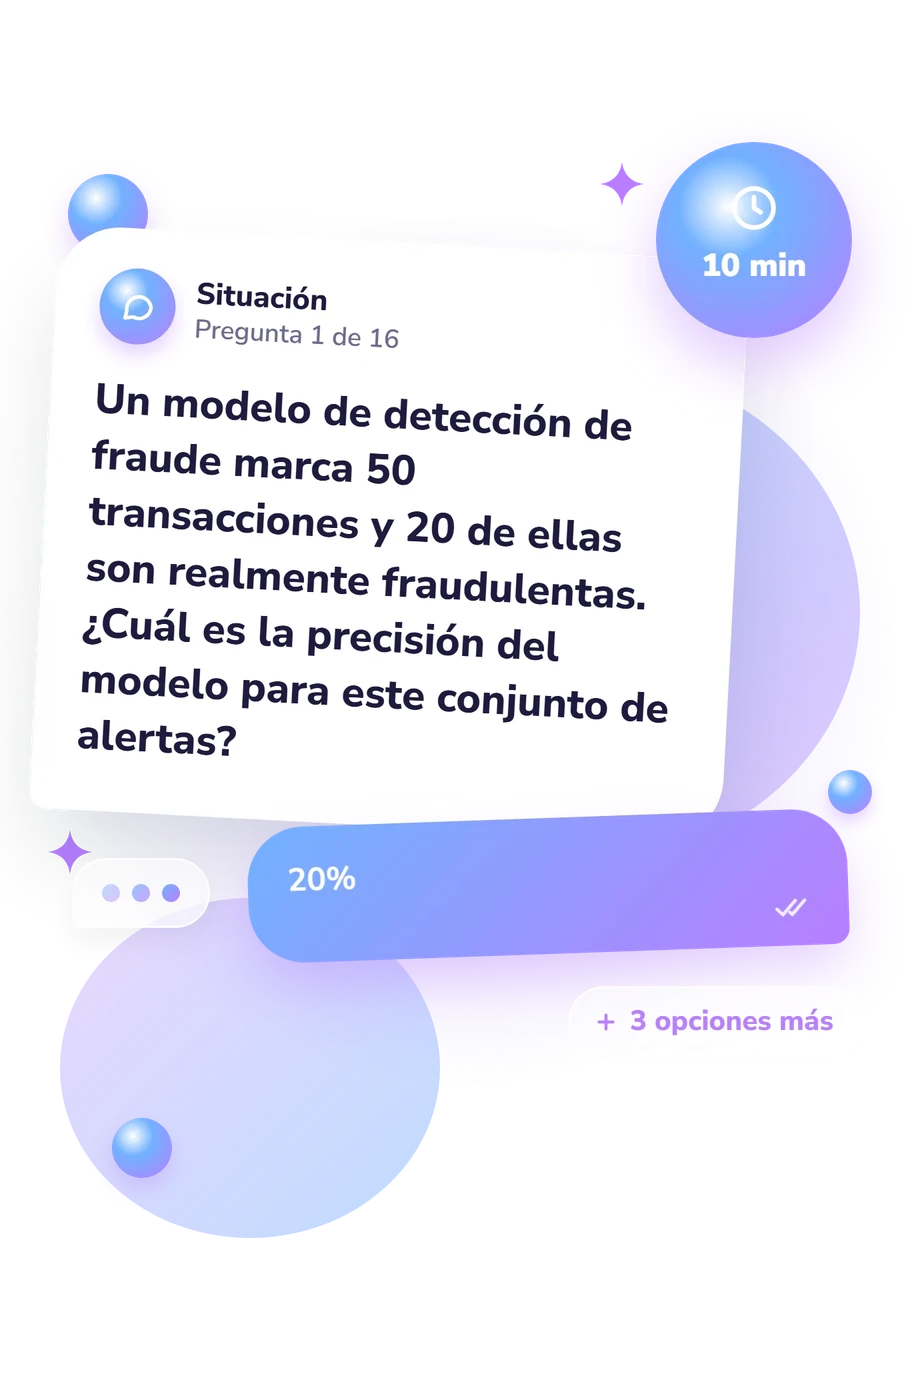
Ejemplos de preguntas de la prueba
- 20%
- 30%
- 40%
- 60%
- INNER JOIN
- CROSS JOIN
- SELF JOIN
- LEFT JOIN
- Una sola variable
- Una estadística de resumen
- Una etiqueta de categoría
- Una sola observación
Test cuestionario de análisis de datos - Descripción y metodología del test
Para quienes quieren revisar su base técnica antes de estudiar, trabajar con informes o interpretar métricas, el Test cuestionario de análisis de datos ofrece una comprobación breve del razonamiento aplicado. Este test de análisis de datos recorre decisiones habituales sobre estadística, SQL, calidad de la información, experimentación y modelos, para situar tu nivel general de comprensión y ayudarte a decidir qué contenidos revisar de manera amplia.
Qué mide este cuestionario
La evaluación está dirigida a quienes necesitan situar sus conocimientos de análisis de datos y comprobar si pueden interpretar situaciones de datos y escoger una respuesta técnicamente defendible. Examina comprensión conceptual y criterio práctico, no una destreza aislada.
Como cuestionario sobre análisis de datos, reúne estos grupos temáticos:
- La estadística distingue media, mediana, variabilidad, error e intervalos según lo que describen realmente.
- La inferencia y la causalidad separan asociaciones, hipótesis y evidencia experimental.
- La preparación y consulta de datos aborda muestras sesgadas, valores faltantes, filtración, uniones y agrupaciones.
- El modelado conecta escalado, métricas de predicción y diseño experimental con decisiones comparables.
El resultado aparece en Conocimientos de análisis de datos (0-16): 0-6, Fundamentos por desarrollar; 7-12, Conocimientos en desarrollo; 13-16, Conocimientos prácticos sólidos. La categoría señala el nivel de comprensión práctica que reflejan tus respuestas.
Metodología y base científica
Cada ítem presenta un problema breve con cuatro alternativas sobre cálculo, interpretación, SQL, calidad de datos o modelado. El formato exige escoger la opción más defendible. El puntaje se obtiene de las respuestas seleccionadas; la regla detallada de ponderación no está documentada, así que el rango no permite deducir cuántos puntos aporta cada opción.
Los ítems son conceptualmente coherentes con aspectos de la alfabetización de datos descritos por Bonikowska et al. (2019), como comprender, evaluar y utilizar datos, y con la relación entre fundamentos, práctica y contexto destacada por Ridsdale et al. (2015). La referencia a estos marcos sirve para describir la relación conceptual de los ítems, no para atribuirles un origen metodológico concreto.
Nath y Kirby (2022), junto con Kirby y Lewis (2026), tratan dimensiones y medición relacionadas. El resultado se interpreta mediante las categorías y rangos mostrados por el cuestionario. Orienta el repaso, aunque depende de la preparación actual, la lectura de los enunciados y la cobertura limitada de una prueba breve.
- Bonikowska, Aneta, Claudia Sanmartin, and Marc Frenette. 2019. Data Literacy: What It Is and How to Measure It in the Public Service. Statistics Canada, Analytical Studies: Methods and References, Catalogue no. 11-633-X, no. 022.
- Ridsdale, Chantel, James Rothwell, Michael Smit, Hossam Ali-Hassan, Michael Bliemel, Dean E. Irvine, Dan E. Kelley, Stan Matwin, and Barbara Wuetherick. 2015. Strategies and Best Practices for Data Literacy Education: Knowledge Synthesis Report. Dalhousie University.
- Nath, Ravi, and Joseph Kirby. 2022. An Empirical Examination of the Factors of Data Literacy. Journal of Digital Science 4(1): 3-20. 10.33847/2686-8296.4.1_1.
- Kirby, Joseph, and Jerome Lewis. 2026. Developing a brief data literacy measure using CFA and IRT. Journal of Librarianship and Information Science 58(1): 223-235. 10.1177/09610006241300738.
Updated: